本章把三项小型合成模拟写成一条可审计的证据链,而不是把模拟数字包装成现实效果。研究问题分别落在文献筛选、候选发现与确认加权、同行评议与资源分配三个环节;它们共享“可复现协议—参数条件—CSV—PNG—运行登记—解释边界”的接口,却不共享生成器、标签、指标或分母。外部文献只负责说明问题为何值得检验、指标应如何界定以及现实外推为何受限;实际数值只来自项目内部的 SIM-8.1、SIM-8.2 和 SIM-8.3,不把合成结果改写成真实数据库、真实科研人员、真实创意质量、录用质量或政策效果。van de Schoot 等van de Schoot 等(2021)和 Ferdinands 等Ferdinands 等(2023)说明筛选排序必须把召回与筛选时序一起看,Callaghan 与 Müller-HansenCallaghan 与 Müller-Hansen(2020)则提醒前瞻停止必须表示尚未筛选记录的抽样不确定性;本章的全库真值已知,因此不会把这些方法背景误写成停止保证。
8.0 实际运行接口与可复现协议
本章把可复现限定为记录环境下的可重复运行,而不是跨环境保证。SIM-8.1、SIM-8.2、SIM-8.3 分别由 simulations/literature_screening.py、simulations/idea_discovery.py、simulations/peer_review.py 生成;登记的 run_id 为 verify-screening-20260925、verify-idea-20260925 和 verify-peer-review-20260925,三个节点均使用 seed 20260925,核验状态均为 verified_reproducible。results/run_manifest.csv 保存脚本哈希、输出清单和状态;具体 UTC 时间、文件哈希与核验细节见 plan/review/simulation-verification.md。同环境运行产生的 16 个 CSV/PNG 产物均与既有产物逐字节一致。
记录环境是 Windows 11、Python 3.13.14、NumPy 2.5.2 和 Matplotlib 3.11.1。三个脚本都固定 seed 20260925;文献筛选用 SeedSequence(seed).spawn(1000) 产生重复种子,创意发现按 pi/d 索引派生随机序列,同行评议用主 SeedSequence(seed).spawn(4) 分离子实验。peer_review.py 不会替调用者创建输出目录,因此同环境复现实验需要先预建 results/ 与 figures/。在仓库根目录执行以下命令即可重算 CSV 和 PNG;这些命令会写入同名输出文件,若需保留既有产物,应先复制到其他位置。
New-Item -ItemType Directory -Force -Path results,figures | Out-Null

python simulations/literature_screening.py

python simulations/idea_discovery.py

python simulations/peer_review.py --seed 20260925
这组命令提供的是记录环境下的同环境复现路径;跨 Python、NumPy、Matplotlib、字体、操作系统或平台的结果没有被测试。
不同 CSV 的 schema 并没有被强行合并。SIM-8.1 的四个文件分别为 1×22、9×54、63×31 和 3×33;SIM-8.2 是一个 192×68 的宽表;SIM-8.3 的五个文件分别为 24×3、5×39、48×37、25×26 和 6×92。S4(x) 表示 x_mean、x_median、x_q025 和 x_q975,D5(x) 还包括 x_defined_fraction、x_p025 和 x_p975。SIM-8.1 与 SIM-8.3 的 schema 没有 defined_fraction 字段;这两个节点写入的 summary 字段均通过有限值检查,但这只说明接口没有未定义输出,不等于现实数据缺失已经被处理。SIM-8.2 的 defined fraction 才是本章对未定义指标的显式分母。本章凡写出的 q025/q975 或 p025/p975,都是固定条件下的重复分布分位数,不能作区间估计或跨研究显著性检验。PNG 只把相应 CSV 画出来,不能从像素反推出未写入 CSV 的数值。以下每个结果段都同时保留条件、指标、均值或中位数、分位数(若写出)、分母或单位以及来源文件。
这种接口把复现与解释分开:参数、随机性和聚合规则可以逐列核对,图像只呈现相同 CSV 的可视化;同一环境的字节一致说明工程输出稳定,不说明现实外部效度。每个条件性结果都需要与指标分母、defined fraction 和构造边界一起阅读。
8.1 合成文献筛选:召回与集中度不是同一目标
8.1.1 生成器、比较设计与字段语义
SIM-8.1 在固定的合成文献生成器中生成 N=10,000 条记录、T=16 个主题和 G=100 个群组,重复次数为 1,000。相关比例是 0.02,因此每次实例按脚本构造得到 target_relevant=200;头部比例是 0.1,冻结的头部群组数为 10,查询目标主题编号为 0|3|8|9,语义分数与潜在相关信号的相关设定为 0.5。筛选深度只有 0.05、0.10 和 0.20,分别对应 k=500、1,000 和 2,000;方法顺序固定为 random、keyword、semantic_noise。这些数字来自 results/literature_screening_parameters.csv,不是对任何真实综述规模的估计。topic_coverage 的分母固定为全部 16 个合成主题,分子是选中记录中出现的不同主题数;query_target_topic_ids=0|3|8|9 只在生成器构造中提高目标主题的 topic_relevance 与 keyword_topics 项,参与潜在相关信号和关键词分数,不改变该指标分母,也不表示目标主题召回。
random 使用与记录属性独立的随机分数;keyword 使用主题关键词、群组项和噪声的合成线性分数;semantic_noise 将标准化潜在相关信号与独立噪声按 0.5 的设定混合。这里的两个名称是脚本内的排序代理,不是关键词产品、语义产品或任何商业系统的名称;semantic_noise 也没有调用现实语义模型。主题覆盖、Shannon 均匀度、有效主题数、头部份额和归一化 HHI 都只是生成结构上的描述量。Clarke 等Clarke 等(2008)区分 novelty 与 diversity,HillHill(1973)提供熵和集中度的数学背景,PricePrice(1965)与 Küçüktunç 等Küçüktunç 等(2014)则提醒头部集中与多样性是不同问题;这些文献支持指标分栏,不为合成数值背书。现实检索中的来源覆盖同样需要与可信度分开读:Zhang 等Zhang 等(2025)的预印本比较发现,基于 LLM 的搜索引擎返回更多独有域名与更多样来源,但在可信度、政治中立与安全性上并无优势;该研究以引用分布为观察口径,不等于质量或召回率测量,且受查询与快照时点局限,因此它只支持“来源多样性收益不等于可信度收益”,不能被读成检索质量或证据可靠性的提高。
literature_screening_parameters.csv 是一行 22 列的参数登记;literature_screening_results.csv 是 9 行 54 列的逐深度、逐方法结果;literature_screening_comparisons.csv 是 63 行 31 列的配对差值;literature_screening_boundary.csv 是 3 行 33 列的零信号边界。一个容易误读的字段是 random_expected_recall:脚本实际计算的是随机选取 k 条时包含全部 200 个相关项的概率,而不是随机方法的平均召回率。深度 0.05、0.10、0.20 的该字段分别为 2.95567562582e-280、3.86911165956e-209 和 4.01341227684e-144;这些极小概率不能写成实际 recall。实际随机 recall 对应 literature_screening_results.csv 的 recall_mean 字段。
8.1.2 负控、召回与深度网格
零信号边界为每个重复生成一个与潜在信号不相关的标准化噪声分数。zero_signal_correlation_mean 为 0.00028915465399,重复分布的 q025–q975 为 -0.0189575568847–0.0193888999732;三个深度的零信号 recall 均值依次为 0.04973、0.09936 和 0.199225,中位数依次为 0.05、0.1 和 0.2。因此脚本预设的 abs(mean)<0.02 且分位数跨过 0 的构造检查通过。这个通过只表示零信号分数没有在生成器内制造出可见的潜在相关关系,且随机抽取的召回随深度接近 depth;它不表示真实标签没有错误、数据库没有漏检,也不提供现实的筛选停止规则。Callaghan 与 Müller-HansenCallaghan 与 Müller-Hansen(2020)所说的未筛选不确定性,在本模拟中因为总体真值已知而没有被模拟。
在同一合成实例上配对比较三个排序时,深度 0.05 的 recall 均值为 random=0.04968、keyword=0.038875、semantic_noise=0.269055;对应的重复分位数分别是 0.025–0.08、0–0.120125 和 0.195–0.365。深度 0.10 时,三个均值依次为 0.09991、0.08061 和 0.42083,重复分位数依次为 0.06–0.14、0.005–0.230125 和 0.33–0.53。深度 0.20 时,三个均值依次为 0.200465、0.185945 和 0.618135,重复分位数依次为 0.149875–0.255、0.03–0.42 和 0.52–0.725。这些是 results/literature_screening_results.csv 的均值和重复分布分位数,不能写成现实筛选工具的召回保证。
在固定深度 0.20、每个方法选 2,000 条时,指标之间的权衡更容易看清。random 的 precision 均值为 0.0200465,topic coverage 均值为 0.9846875,Shannon evenness 均值为 0.831460265069,有效主题数均值为 10.1241731163,head share 均值为 0.200256,归一化 HHI 均值为 0.0016334530303。keyword 对应的 precision、topic coverage、Shannon evenness、有效主题数、head share 和归一化 HHI 均值分别为 0.0185945、0.63425、0.488633310248、4.21962087391、0.208713 和 0.00289083434343。semantic_noise 对应的六个均值分别为 0.0618135、0.979375、0.781270284112、8.881308069、0.314665 和 0.00645551818182。因此,较高 recall 与较高 head share、较高归一化 HHI 同时出现;topic coverage 接近并不等于主题完整性、科学质量或公平性。Feng 等Feng 等(2022)和 Ferdinands 等Ferdinands 等(2023)关于召回与残余漏检的经验边界,只能帮助我们理解为什么要保留这些并列指标,不能把这里的数值移植到真实医学或综述筛选。
配对差值进一步把“同一实例内的变化”与跨实例绝对值区分开来。semantic_noise - random 的 recall 配对差值在深度 0.05、0.10、0.20 分别为 0.219375、0.32092 和 0.41767;相应重复分位数分别为 0.14–0.315、0.219875–0.44 和 0.304875–0.525。这些差值来自 literature_screening_comparisons.csv,不是独立样本之间的显著性比较。它们只说明在当前潜在信号、主题结构、头部结构和 seed 下,带噪声语义代理的排序位置发生了条件性变化。
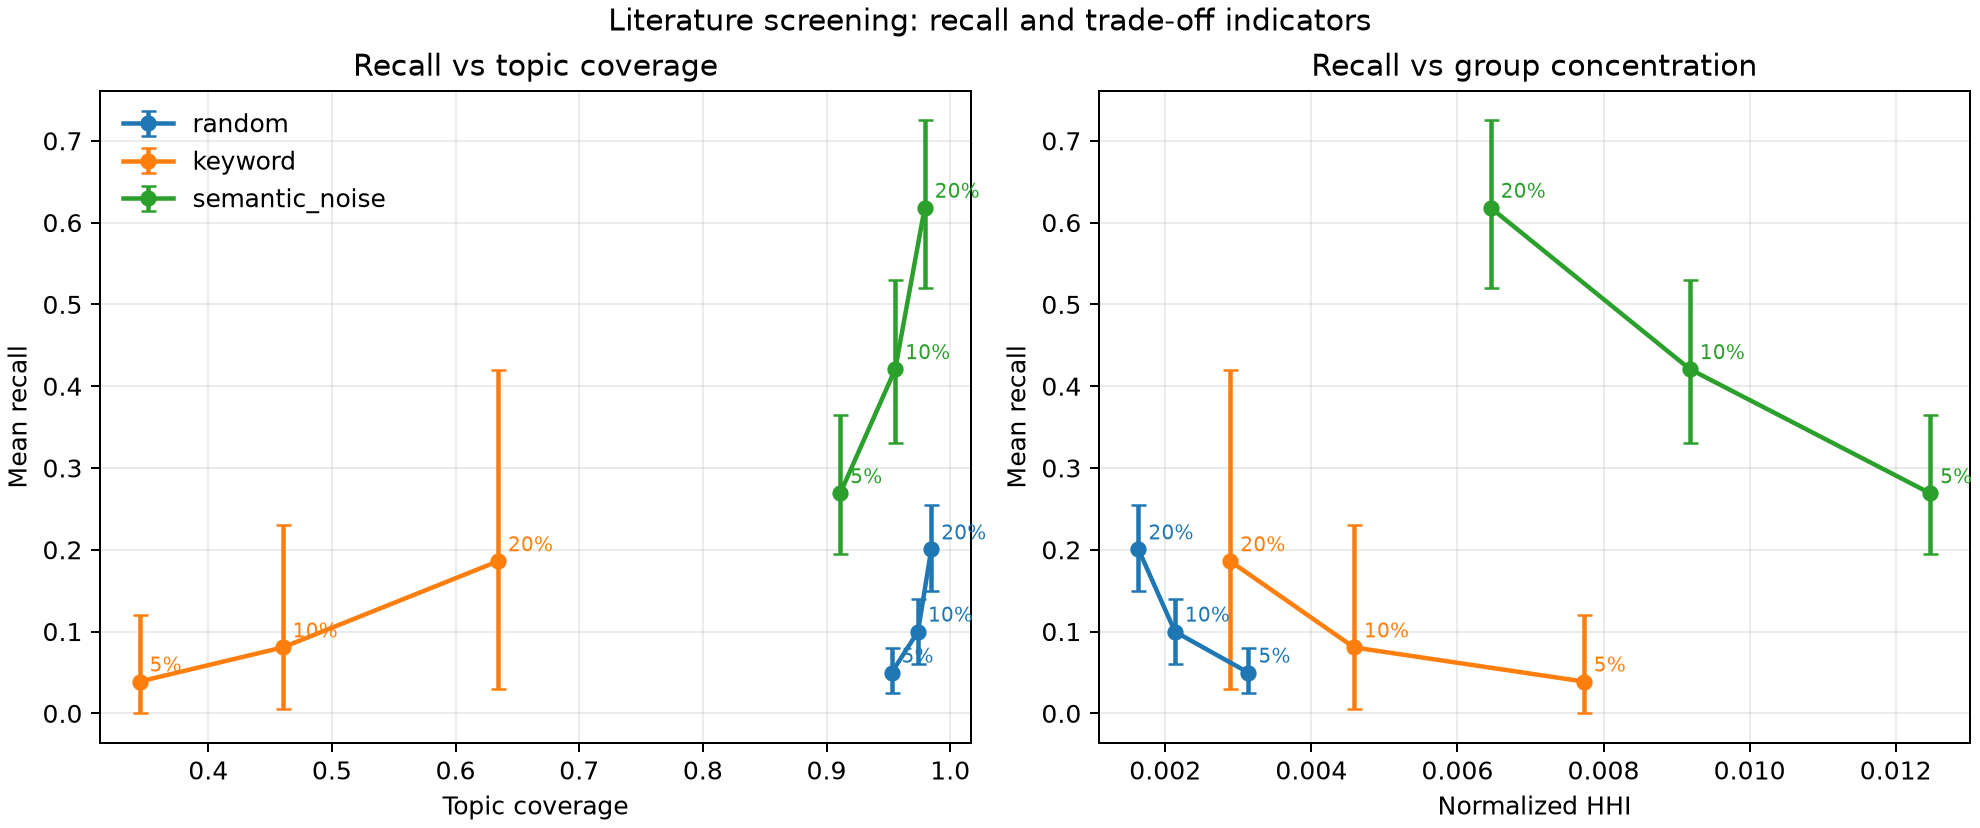
图8-1 的数据来自 results/literature_screening_results.csv,把固定深度下的均值 recall 与 topic coverage、归一化 HHI 放在同一视图中;topic coverage 的分母固定为全部 16 个合成主题,目标主题 ID 只参与潜在相关信号构造。误差条表示重复分布的 q025–q975。图的用途是定位召回与集中度的条件性权衡,不能增加 CSV 中没有的比较,也不能把 semantic_noise 画成现实 AI 产品。
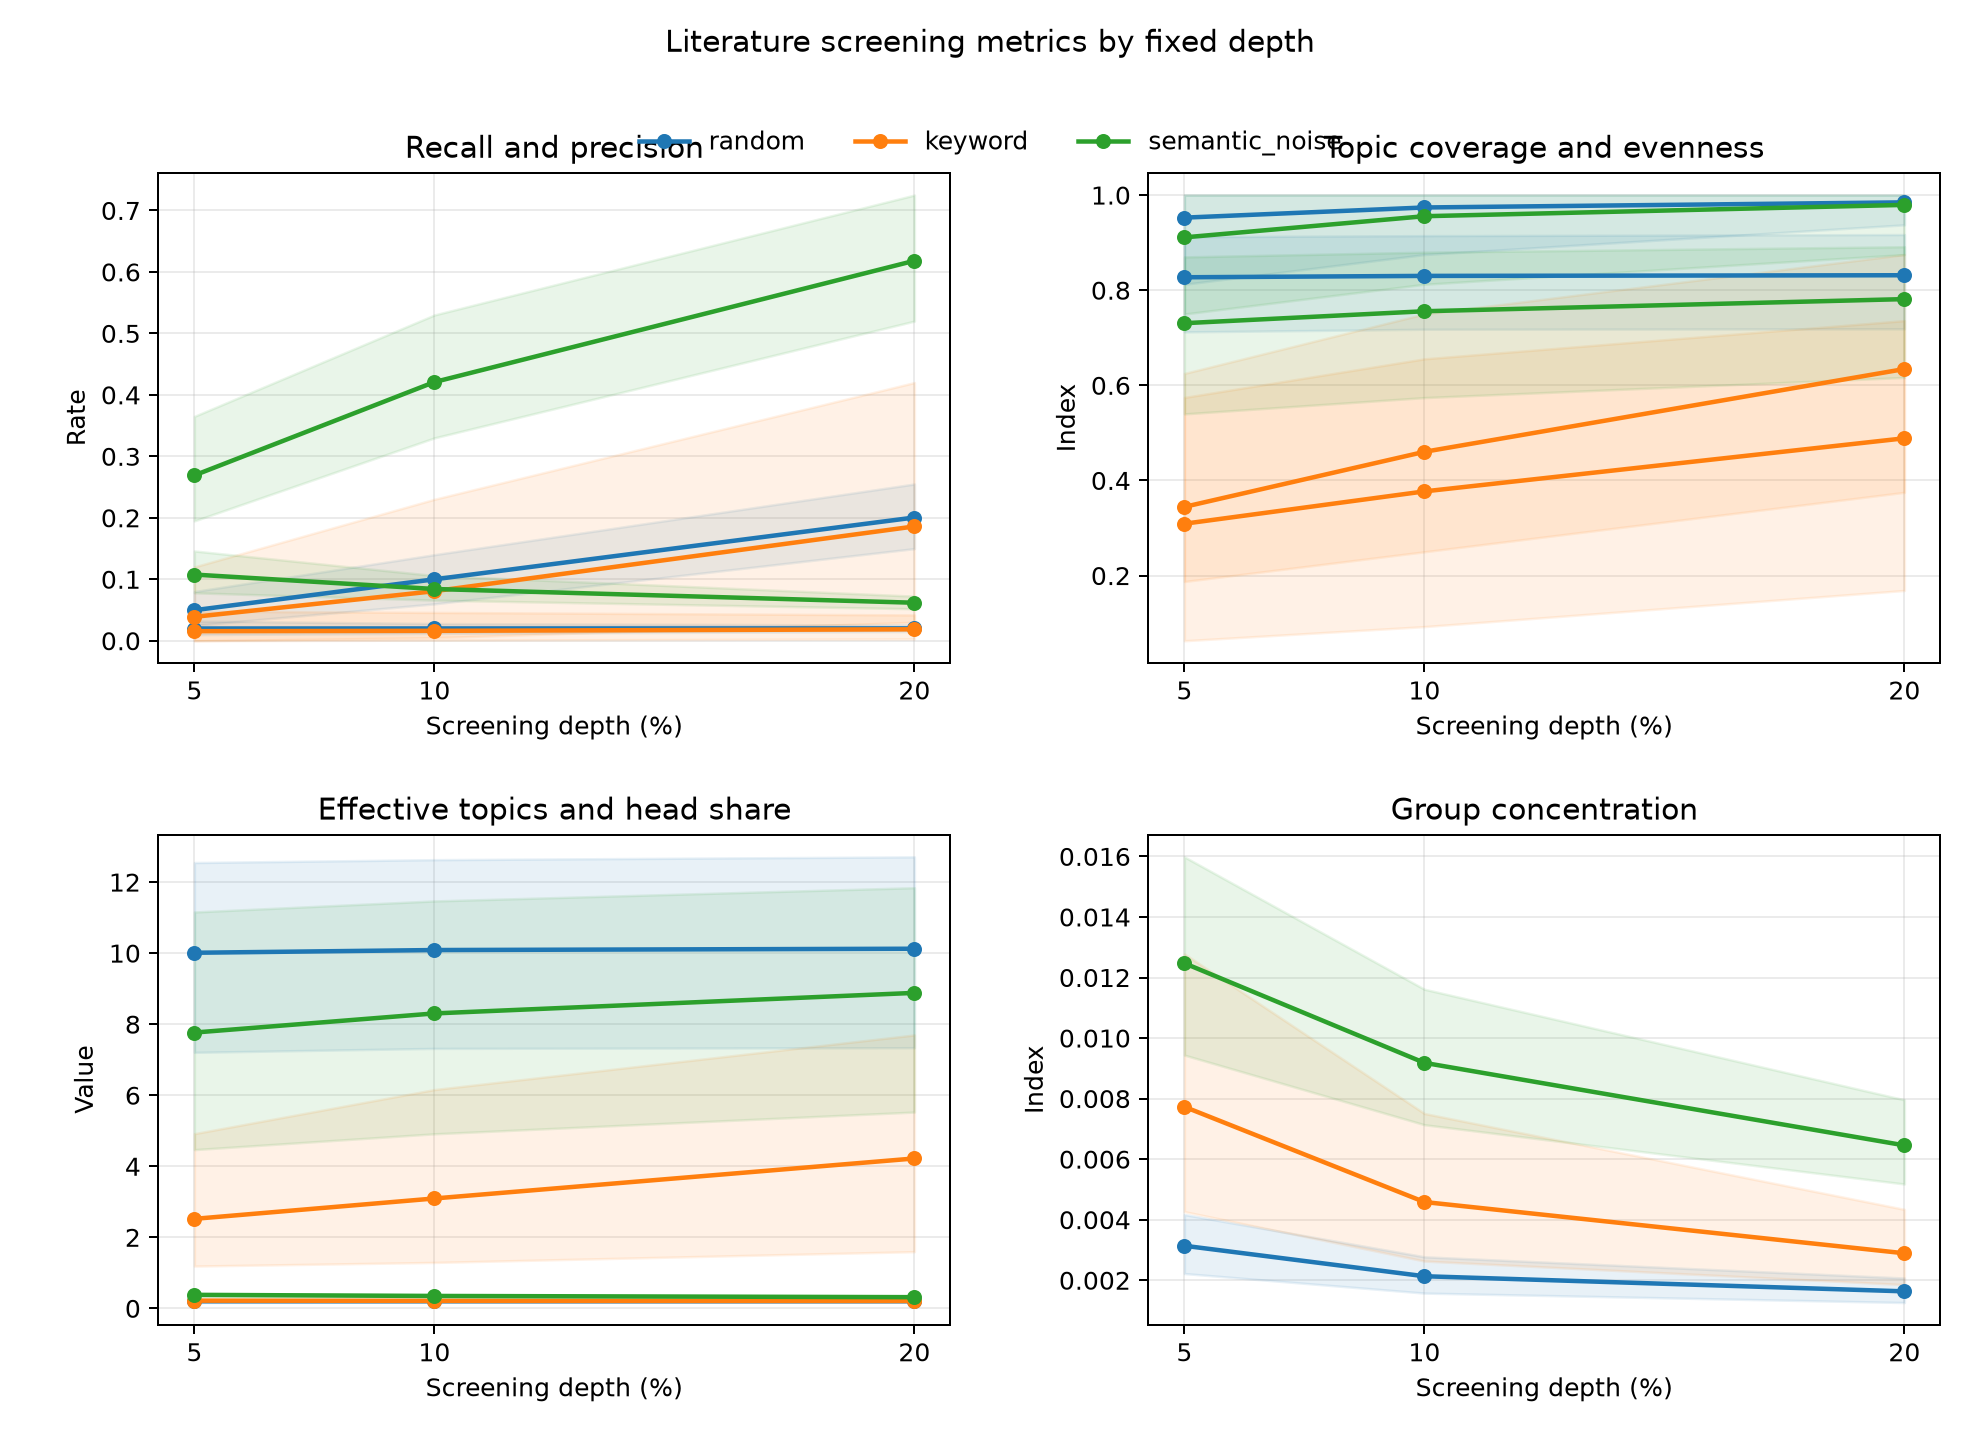
图8-2 的数据来自同一结果 CSV,展示 0.05、0.10 和 0.20 三个深度上的 recall、precision、topic coverage、Shannon evenness、有效主题数、head share 和归一化 HHI;topic coverage 的分母仍是全部 16 个合成主题,目标主题 ID 只参与潜在相关信号构造。阴影带是重复分布分位数,不是区间估计;图只覆盖当前合成网格,不能延伸为真实数据库的停止曲线。
8.2 合成选题与确认加权:发现率与验证负担必须并列
8.2.1 设计、负控与指标口径
SIM-8.2 把 m=10,000 个合成候选、每个参数单元 1,000 次重复、pi 网格 0.001|0.005|0.01|0.05、d 网格 0|0.5|1|2、预算比例 B/m 网格 0.001|0.005|0.01|0.05 和三种确认权重放在一起。方法为 neutral、cb_1 和 cb_2,对应的 c_cb 是 0、1 和 2;lambda_cb 固定为 0.5。四个 pi、四个 d、四个预算比例和三种方法组成 4×4×4×3=192 行。data_kind 为 synthetic_scenario,不是实际项目库。候选排序分数由合成信号和噪声构成,cb_1 与 cb_2 只是在分数上加入合成信念项的机制代理,不能称为科学家的心理系数,也不能把 pi、d 或 B/m 写成现实创新率、信噪比或机构预算。每个重复先重新生成 m=10,000 个 z、误差和分数,再以 belief_logit=lambda_cb*tanh(centered_score) 形成概率并抽样 belief;因此 belief 是由本轮分数内生生成的标签,不是预先存在的群体或现实心理变量。同一轮的三种方法共享这批 z、分数和 belief,跨重复则重新生成候选总体;固定的是规模、参数网格和生成器,不是同一批已实现候选。
8.2 的结果表同时保存 defined_fraction。当一次重复没有真实命中时,validations_per_tp 的分母为零;当某个信念组为空时,recall_b0、recall_b1 和 belief_gap 不能计算。脚本没有把未定义值替换成零,而是用 defined fraction 标记可计算重复所占比例,再在可计算值上给出均值、中位数和 p025–p975。fdp_single 是单次已选集合中的假发现比例,满足 1-precision,不是总体 FDR;Benjamini 与 HochbergBenjamini 与 Hochberg(1995)提供的是错误控制的概念背景,不能替这个脚本生成现实 FDR 保证。Button 等Button 等(2013)关于低功效和赢家诅咒的讨论也不能被转写成 AI 选题的心理或统计参数。
当 d=0 时,脚本把无信号排序作为负控。在 pi=0.01、B/m=0.01 的中性方法行,recall 均值为 0.010095284212046387,重复分布 p025–p975 为 0–0.03225806451612903,precision 均值为 0.010080000000000002,fdp_single 均值为 0.9899200000000001。该行的 recall_defined_fraction 和 fdp_single_defined_fraction 都是 1.0,但 validations_per_tp_defined_fraction 只有 0.652;其验证负担均值为 77.06799591002044,p025–p975 为 33.333333333333336–100.0。同一行的 hit_fraction 是 0.652,no_true_hit_fraction 是 0.348。对全网格 d=0 行与预算比例做核对,|recall_mean-budget_ratio| 的最大值为 0.0032422530143548373,小于预设容差 0.05。这只验证无信号排序接近预算比例的构造边界。
8.2.2 信号强度、确认权重与未定义比例
在 pi=0.01、B/m=0.01、method=neutral 的切片中,d=0.5 时 recall 均值为 0.9405999847441469,p025–p975 为 0.8333333333333334–1.0,precision 均值为 0.94096,fdp_single 均值为 0.05904000000000001;validations_per_tp 的 defined fraction 为 1.0,均值为 1.0668289298215672,p025–p975 为 1.0–1.25;belief_gap 的 defined fraction 为 1.0,均值为 0.0010134238393150951,p025–p975 为 -0.09095117845117848–0.10114384270454596。d=1 时 recall 均值为 0.9629986195324659,p025–p975 为 0.8331611570247934–1.0,precision 为 0.96157,fdp_single 为 0.038430000000000006,验证负担均值为 1.0437535933410023,defined fraction 为 1.0。d=2 时 recall 均值为 0.9630728171378528,p025–p975 为 0.8264462809917356–1.0,precision 为 0.95894,fdp_single 为 0.04106,验证负担均值为 1.0473787573669644,defined fraction 同为 1.0。从 d=0.5 到 d=1 的 recall 上升伴随 fdp_single 下降,但从 d=1 到 d=2 的 recall 只发生很小变化;这属于当前信号生成器的条件性饱和,不是现实发现能力的普遍曲线。Si 等(2025a、2025b)关于初始新颖性与执行后价值的区分(其实验模型为 GPT-4o 级,代际归属存疑),以及 Szymanski 等Szymanski 等(2023)关于封闭候选池的边界,都支持把“被选中”与“最终有价值”分开。
在 pi=0.01、d=0.5、B/m=0.01 的同一 pi×d×B/m 条件内,neutral、cb_1、cb_2 的 recall 均值依次为 0.9405999847441469、0.9155682086621664 和 0.8357101634393642;其 p025–p975 分别为 0.8333333333333334–1.0、0.8275487256371814–0.9767441860465116 和 0.7692307692307693–0.9054173290937997。三种方法的 recall defined fraction 都是 1.0。belief_gap_mean 依次为 0.0010134238393150951、0.1478223023383106 和 0.40192735775828864,belief gap 的 defined fraction 都是 1.0;对应的 p025–p975 分别为 -0.09095117845117848–0.10114384270454596、0.01909701237272629–0.31112895158063225 和 0.24242424242424243–0.5757907196969696。同时,fdp_single_mean 依次为 0.05904000000000001、0.08370000000000001 和 0.16274,validations_per_tp_mean 依次为 1.0668289298215672、1.096110149245193 和 1.2020049090864562,其 defined fraction 均为 1.0。这组结果显示,在该合成切片内,确认权重增加与总体 recall 下降、信念组 recall gap 扩大、验证负担上升同时出现;它不能证明现实科学家有同样的偏误,也不能推出停止探索或限制选题自由的政策结论。
全网格中 validations_per_tp 的最大未定义比例为 0.988,belief_gap 的最大未定义比例为 0.02200000000000002。这两个数字必须和对应均值一起读:未定义比例高的行,其均值只代表 defined fraction 所覆盖的重复,不是把未定义重复当作零后的完整分布。NickersonNickerson(1998)提供确认敏感证据筛选的概念背景,但 c_cb 与 lambda_cb 仍然是本项目的情景参数。筛选、发现、执行和验证的界线在合成表中可以拆开,现实中则还需要独立经验资料。
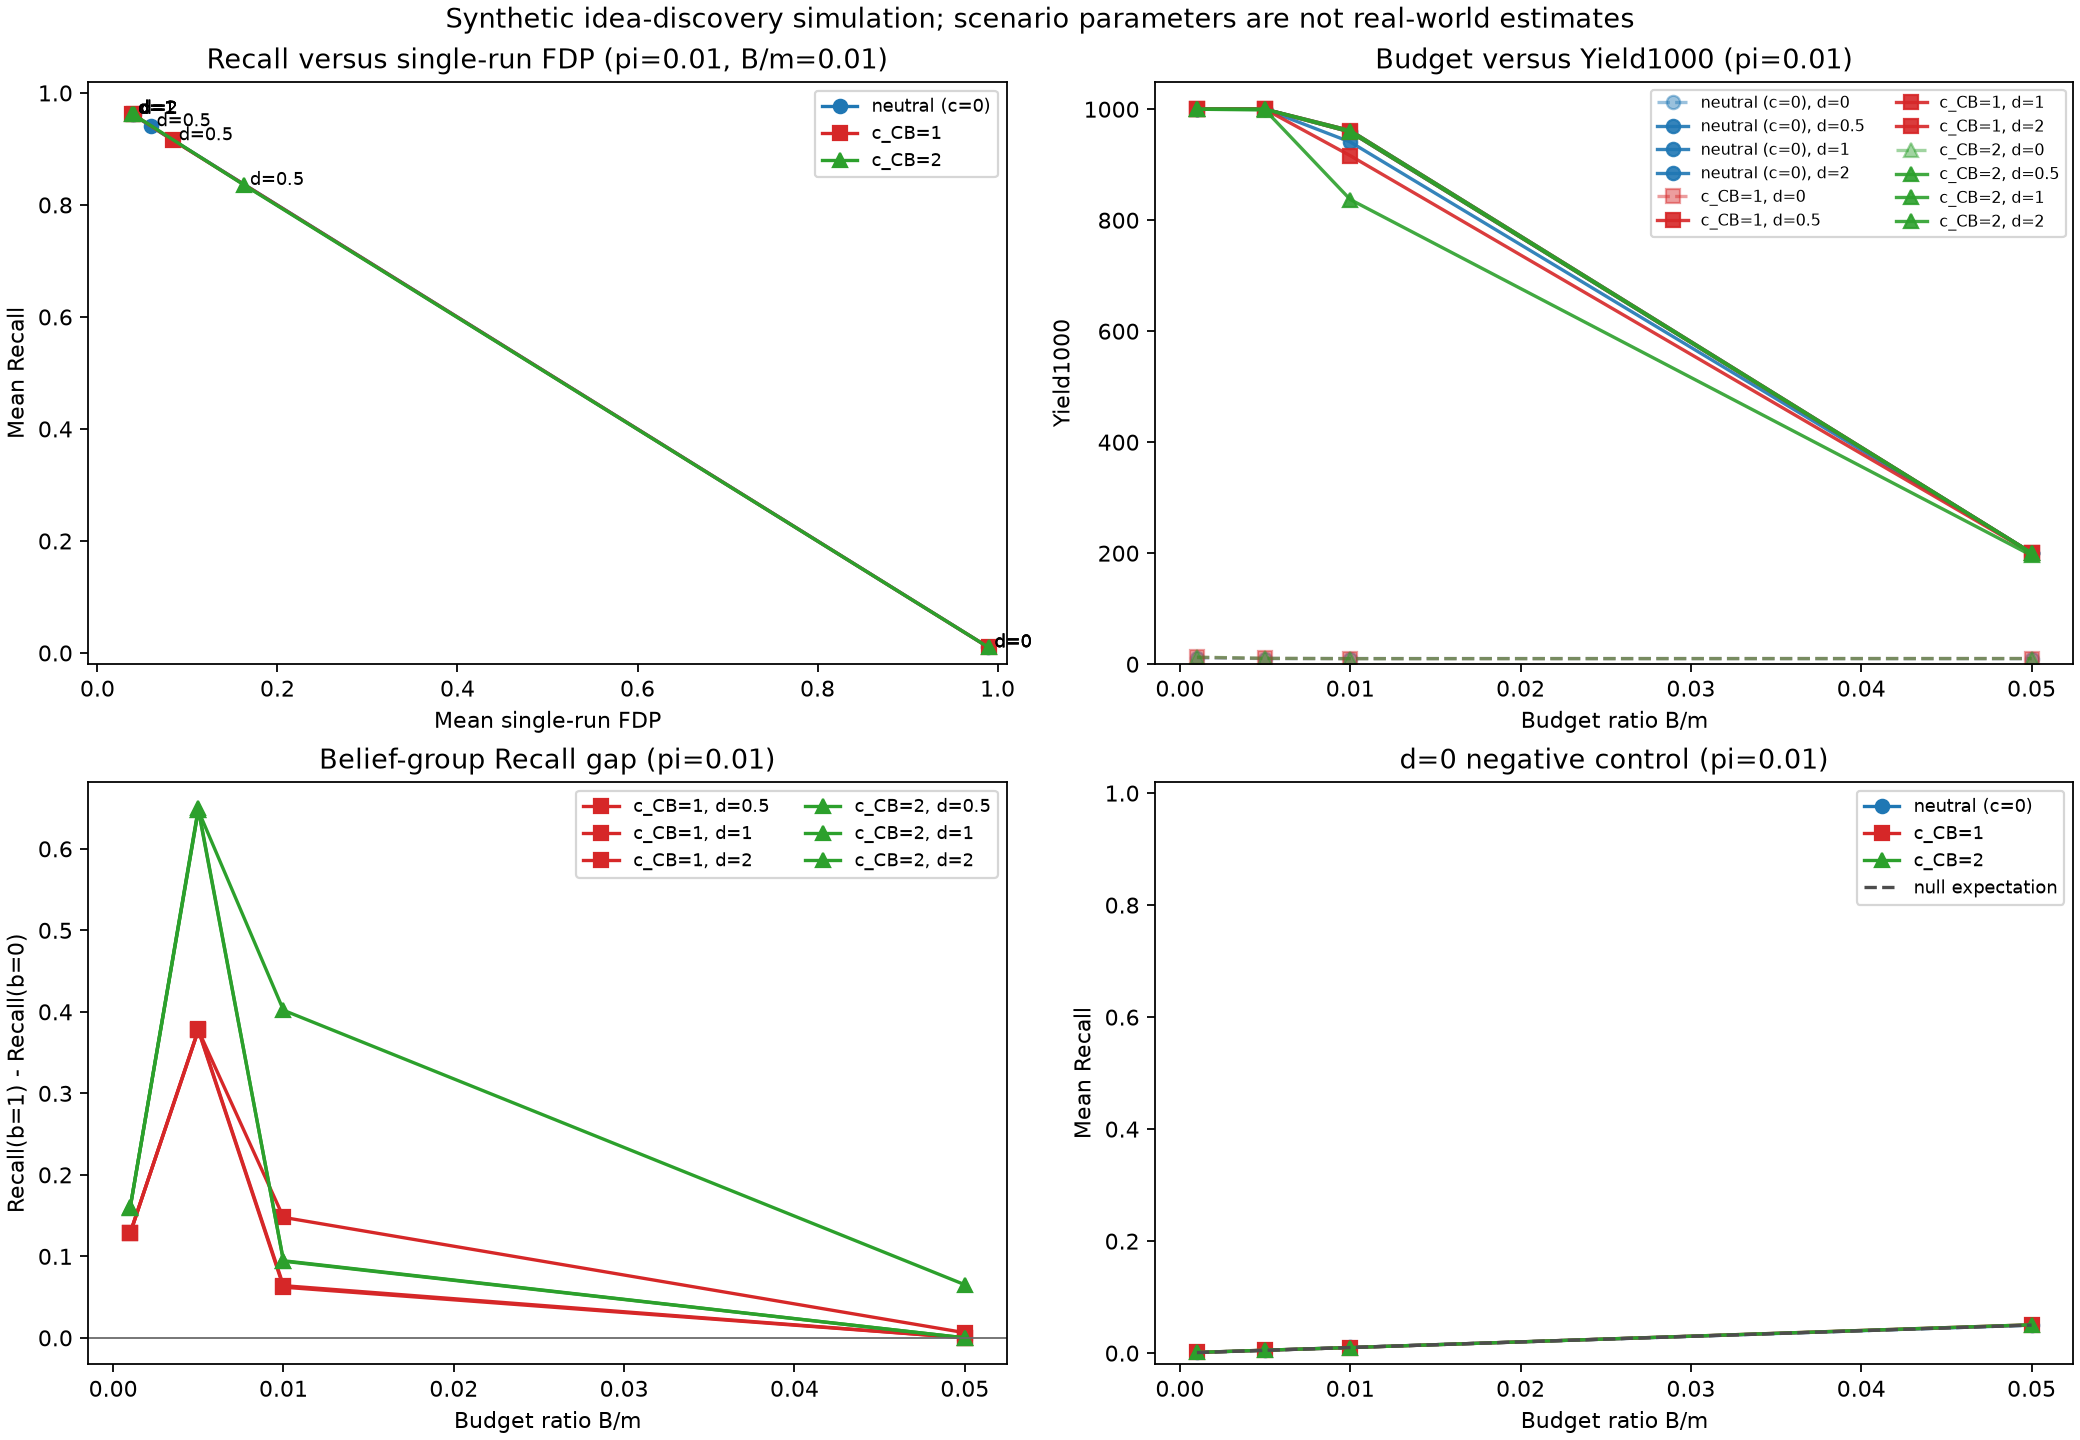
图8-3 来自 results/idea_discovery_summary.csv,四个面板的条件范围各不相同。左上面板固定 pi=0.01、B/m=0.01,对应 d=0|0.5|1|2 和 method=neutral|cb_1|cb_2;右上面板固定 pi=0.01,对应 B/m=0.001|0.005|0.01|0.05、d=0|0.5|1|2 和 method=neutral|cb_1|cb_2;左下面板固定 pi=0.01,对应 B/m=0.001|0.005|0.01|0.05、d=0.5|1|2 和 method=cb_1|cb_2;右下面板固定 pi=0.01、d=0,对应 B/m=0.001|0.005|0.01|0.05 和 method=neutral|cb_1|cb_2。四幅子图分别展示 recall 与单次 FDP、预算与 Yield1000、信念组 recall gap 以及零信号负控;Yield1000 是每 1,000 次验证的合成真发现数,不是现实每千项产出。图中任何线段都不能替代 defined fraction,也不能把 belief_gap 命名为现实心理或身份差异。
8.3 合成同行评议:共识、准确性与资源覆盖
8.3.1 生成器、异质性与主混合权重
SIM-8.3 每次重复生成 M=1,000 篇合成稿件、每个参数单元 1,000 次重复和 3 名评审者。主 omega 网格是 0.0|0.25|0.5|0.75|1.0;基础能力向量是 0.20|0.50|0.80,严厉度标准差是 0.20,稿件—评审者特异噪声标准差是 0.40,AI 质量载荷是 0.80,AI 合成群组载荷是 0.10,主 AI 共同误差标准差是 0.40,接收阈值为质量最高的 0.2 比例。group_labels=-1|+1 是与质量独立的抽象随机二分,不是任何真实身份、地位或期刊群。gittins_index_computed=False 也已经写入 results/peer_review_parameters.csv;本章不把未计算的动态分配指数当作基准。
peer_review_parameters.csv 有 24 行 3 列,记录上述参数及其描述;peer_review_omega_summary.csv 有 5 行 39 列,记录五个 omega 的 MAE、决定误差、稿件内 WSD、决定共识、合成组偏差、组 MAE、接收率、阈值、人审覆盖和平均评审数;peer_review_parameter_sensitivity.csv 有 48 行 37 列,覆盖 low、middle、high 三个能力 profile 与严厉度、特异噪声网格;peer_review_common_error_mechanism.csv 有 25 行 26 列,覆盖共同误差标准差 0.0|0.2|0.4|0.8|1.2;peer_review_allocation_sensitivity.csv 有 6 行 92 列,比较额外评审比例 0.25 和 0.50 下的三种同预算策略。能力 profile 是脚本参数,不是个人能力测量;本节点没有独立的零效应对照,结构检查不能替代负控。Bornmann 等Bornmann 等(2010)关于评审可靠性异质性的综述、Giannakakos 等Giannakakos 等(2025)关于身份与制度差异的综述,以及 Liang 等Liang 等(2024)、Thakkar 等Thakkar 等(2026)和 Zhu 等Zhu 等(2025)关于 AI 反馈的研究,都只能支持现实问题的背景与限制,不能替合成组或合成阈值赋予现实含义。这三项 AI 反馈研究的模型基线也需标明:Liang 等Liang 等(2024)为单一模型与提示条件,Zhu 等Zhu 等(2025)的实测对象是 2023 年的 Claude 2.0,Thakkar 等Thakkar 等(2026)未标明所用模型与版本,因此它们不能默认代表当前代评审能力。
在主 omega 网格中,omega=0 的 MAE 均值为 0.4555083041242573,q025–q975 为 0.42711331530309826–0.496589296540987;决定误差均值为 0.14011,分位数为 0.101975–0.175;WSD 均值为 0.4743587499214464,分位数为 0.4327090861602604–0.5667043457008368;决定共识均值为 0.763083,分位数为 0.636–0.8590249999999999。omega=0.75 时,MAE 均值为 0.3384328809147124,分位数为 0.32214942892481346–0.3544919910549707;决定误差为 0.096117,分位数为 0.081–0.113;WSD 为 0.1185896874803616,分位数为 0.10817727154006508–0.1416760864252092;决定共识为 0.933361,分位数为 0.904975–0.955。omega=1 时,MAE 为 0.365868045179206,分位数为 0.34845924036237136–0.3822609518677753;决定误差为 0.103751,分位数为 0.087–0.12102499999999998;WSD 均值为 2.2321969010451674e-17,分位数为 1.856034416303455e-17–2.649814484237927e-17;决定共识为 1.0。中间网格的 MAE 均值在 omega=0.25 和 omega=0.5 分别为 0.38902094528095926 和 0.3468656564424793,决定误差分别为 0.12015700000000001 和 0.10190200000000002,WSD 分别为 0.35576906244108475 和 0.2371793749607232。这些是合成混合权重下的结构关系;omega=1 的共识和 WSD 接近常数,主要因为同一 AI 分数被共享给评审者,并不等于真实评审质量提高。
主表的 group_bias_mean 在五个 omega 行均为 0.20000000000000004,human_coverage_mean 均为 1.0,avg_reviews_per_manuscript_mean 均为 3.0。前一个数字是脚本给抽象组加入的对称构造项,后两个数字是主情景的三名评审覆盖与平均数;它们不是现实歧视率、公平指标或期刊录用质量。decision_acceptance_rate_mean 在五个 omega 行依次为 0.069858、0.087727、0.113794、0.144025 和 0.174493,但接收阈值本身是质量最高的 0.2 比例这一合成规则,因此不能用这些值评价真实编辑决定。
8.3.2 共享误差、能力敏感性与资源分配
共享误差机制把 AI 的同一误差项同时传给同一稿件的所有评审者。在 sigma_ai_common_error=1.2 的行中,omega=0 的 MAE 均值为 0.4559180495134294,q025–q975 为 0.4283408323221627–0.4927372936198005,WSD 均值为 0.4712703780355678,q025–q975 为 0.43517007732558–0.5557453855823946;omega=1 的 MAE 均值为 0.9750834165700958,q025–q975 为 0.9289443724446511–1.019621707583249,WSD 均值为 3.708901992939042e-17。CSV 的 mae_change_omega0_to_1_mean 为 0.5191653670566664,wsd_drop_omega0_to_1_mean 为 0.47127037803556776,min_mae_omega 为 0.25,pseudo_consensus_pattern 为 1。这个派生标志只表示“离散度下降同时 MAE 上升”的脚本模式被触发,不是经验证的“伪共识”构念;它说明共享错误可以制造看起来更一致的结果,却没有自动提高评分准确性。
在 severity_sd=0、specific_noise_sd=0.1、omega=0.5 的同一敏感性切片中,low、middle、high 三个能力 profile 的 MAE 均值依次为 0.3839982502704577、0.315807154772067 和 0.26887152461026964;相应 q025–q975 依次为 0.3675230858733244–0.40140022775042、0.3013038754989827–0.33001816718634835 和 0.2564091429425276–0.28118533196864415。决定误差均值依次为 0.11990100000000001、0.093664 和 0.07717099999999999,WSD 均值依次为 0.07711268009926141、0.0942372987054469 和 0.09423165484466484,决定共识均值依次为 0.950192、0.9366720000000001 和 0.939439。三行的人审覆盖都是 1.0,平均评审数都是 3.0,合成组偏差均值都是 0.20000000000000004。这些差异只表明在当前评分载荷、严厉度和特异噪声条件下,能力 profile 改变了合成分数误差;它不评价真实评审者,也不把 profile 写成能力等级或公平裁决。
分配规则先计算 distance = |ai - theta|,其中 ai 是合成 AI 分数,theta 是接收阈值;distance 越小,稿件越靠近阈值。每篇稿件初始有一次人审,extra_count = round(M×extra_fraction),所有策略都要求 sum(counts)=M+extra_count,所以预算只在稿件之间重新分配。uniform_extra 用 evenly_spaced_ids 选取均匀间隔的稿件并将其计数设为 2,其余保持 1;boundary_min_one 按 distance 升序把前 extra_count 篇设为 2,其余保持 1,因此不取消人审;boundary_reallocating 令 zero_count=min(extra_count,(M-extra_count)//2),把最近的 extra_count+zero_count 篇设为 2,并把最远的 zero_count 篇设为 0。计数为 0 的稿件由 AI-only 分数作最终结果,取消人审但仍计入相同总预算;counts.sum() 的守恒检查防止策略偷偷增加资源。资源分配实验固定 omega=0.5,并在同一 target_total_reviews 下比较策略。额外比例为 0.25 时目标总评审数为 1,250,平均评审数为 1.25。uniform_extra 的 MAE、决定误差和人类覆盖均值分别为 0.3756647705322033、0.10923700000000001 和 1.0,多次评审覆盖为 0.25,无人类评审覆盖为 0.0,组资源差距为 0.008795200000000008;其 decision_consensus_reviewed_mean 为 0.9782819999999999,decision_consensus_multi_review_mean 为 0.9131280000000002。boundary_min_one 的 MAE、决定误差和人类覆盖分别为 0.3756362844917081、0.108424 和 1.0,组资源差距为 0.019940800000000015;两个共识字段分别为 0.932979 和 0.731916。boundary_reallocating 的 MAE、决定误差和人类覆盖分别为 0.3540243762310522、0.10438400000000002 和 0.75,多次评审覆盖为 0.5,无人类评审覆盖为 0.25,组资源差距为 0.056804800000000044;两个共识字段分别为 0.8861613333333334 和 0.8292419999999999。相对于均匀分配,boundary_reallocating 的覆盖变化为 -0.25,MAE 变化为 -0.02164039430115111,决定误差变化为 -0.004853。这正是同预算下的覆盖—误差—资源分布权衡,不是“把 AI 无人审稿件”命名为公平或安全。
额外比例为 0.50 时目标总评审数为 1,500,平均评审数为 1.5。uniform_extra 的 MAE、决定误差、人类覆盖和组资源差距均值分别为 0.36726072542638033、0.107295、1.0 和 0.008164000000000005;boundary_min_one 分别为 0.36630911650479947、0.104415、1.0 和 0.025193333333333352;boundary_reallocating 分别为 0.34708492943150765、0.103798、0.75 和 0.0442506666666667。boundary_reallocating 的多重评审覆盖为 0.75,无人类评审覆盖为 0.25,相对于均匀分配的覆盖变化仍为 -0.25,MAE 变化为 -0.020175795994872642,决定误差变化为 -0.0034970000000000005。这里的 human_coverage 只表示有至少一次人类评审的合成稿件比例,ai_only_coverage 只表示没有人类评审的比例;两者都不是公平性指标。GittinsGittins(1979)的动态分配规则依赖独立项目、已知状态转移和可停止条件,本脚本没有计算该指数,不能把任一策略称为现实最优。
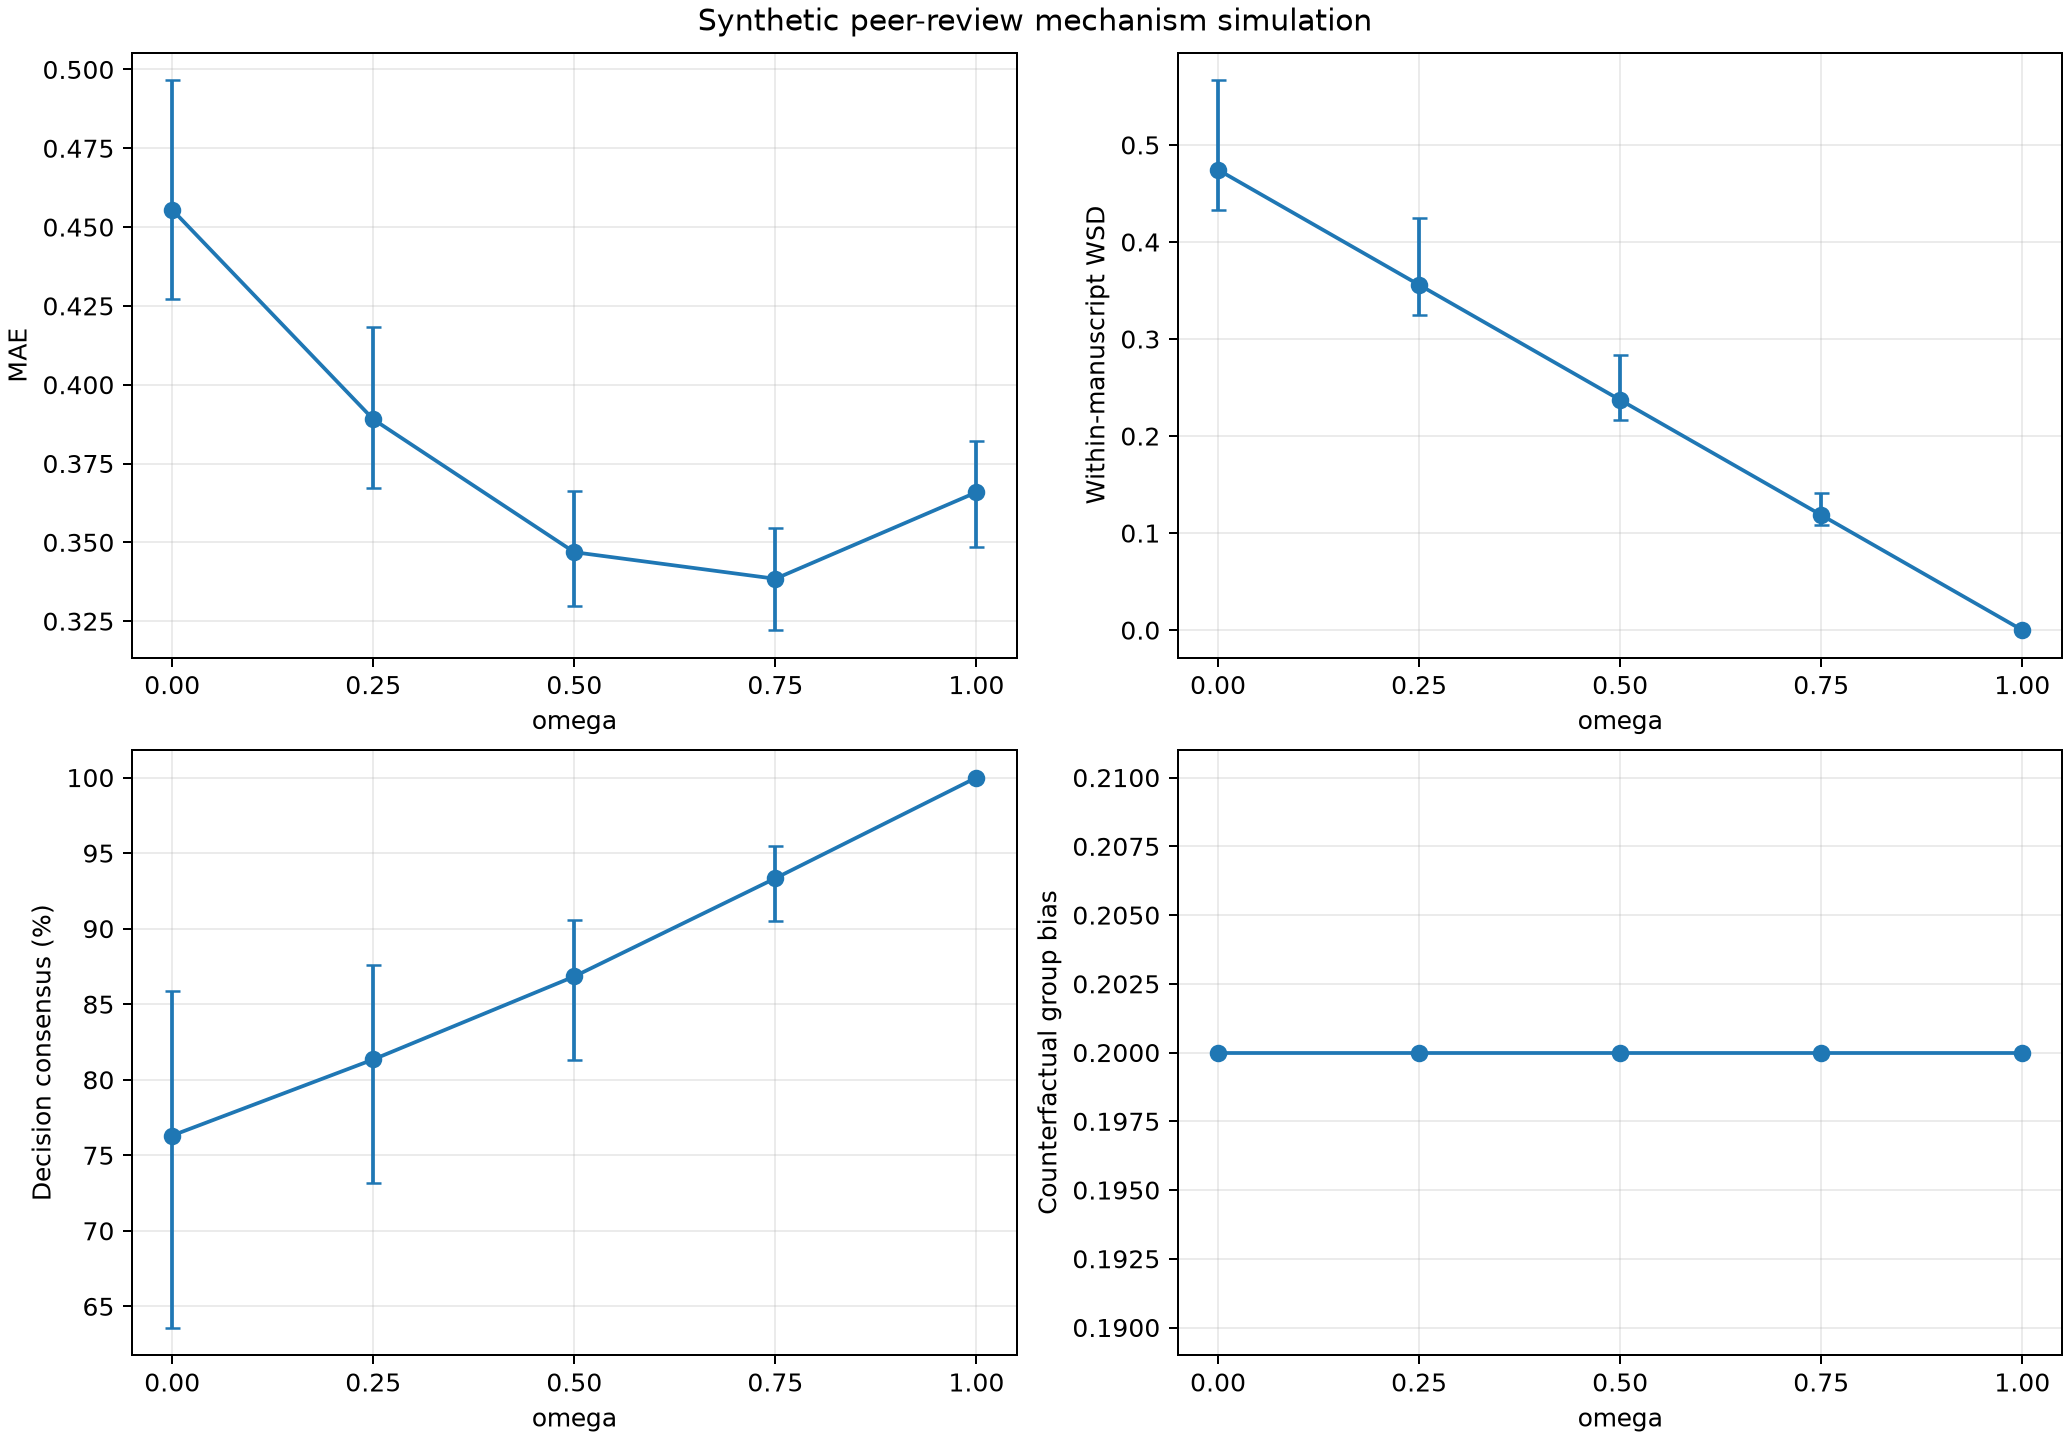
图8-4 的数据来自 results/peer_review_omega_summary.csv,展示 omega=0.0|0.25|0.5|0.75|1.0 下 MAE、WSD、决定共识和合成组偏差的均值;误差条是重复分布的 q025–q975。omega=1 的 WSD 压缩和决定共识上升应与 MAE、决定误差一起读,不能单独解释为真实评审更准确。
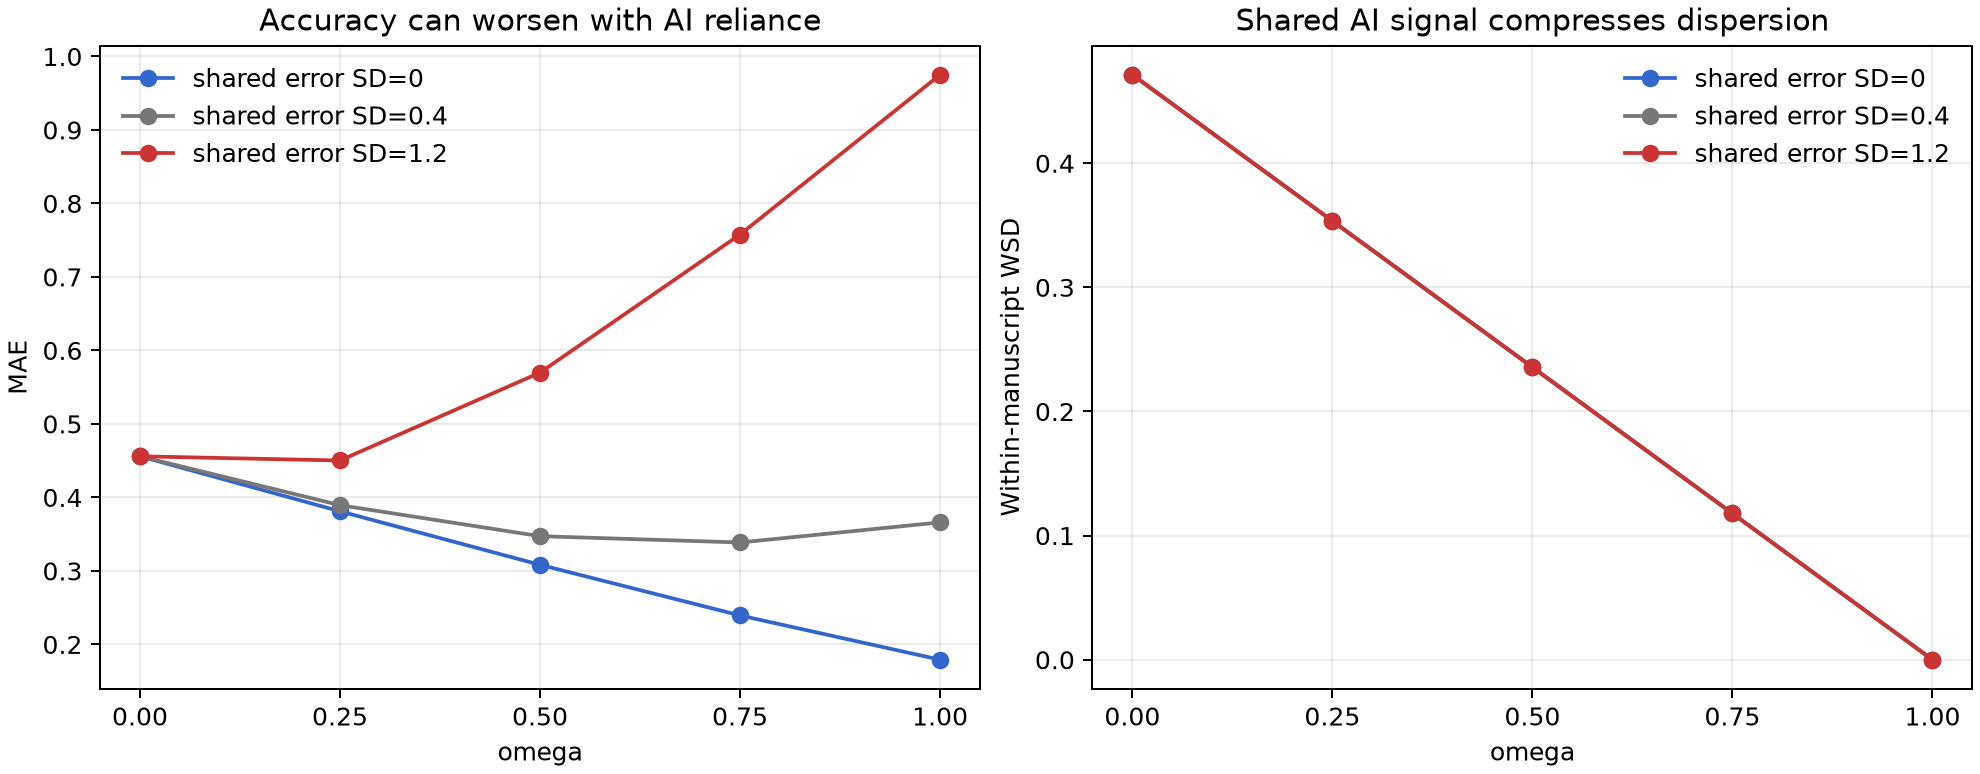
图8-5 的数据来自 results/peer_review_common_error_mechanism.csv,选取共同误差标准差 0.0、0.4 和 1.2 的曲线,比较 MAE 与 WSD 随 omega 的变化。它用于显示共享误差的机制条件;pseudo_consensus_pattern 是脚本派生标志,不是现实构念或独立负控。
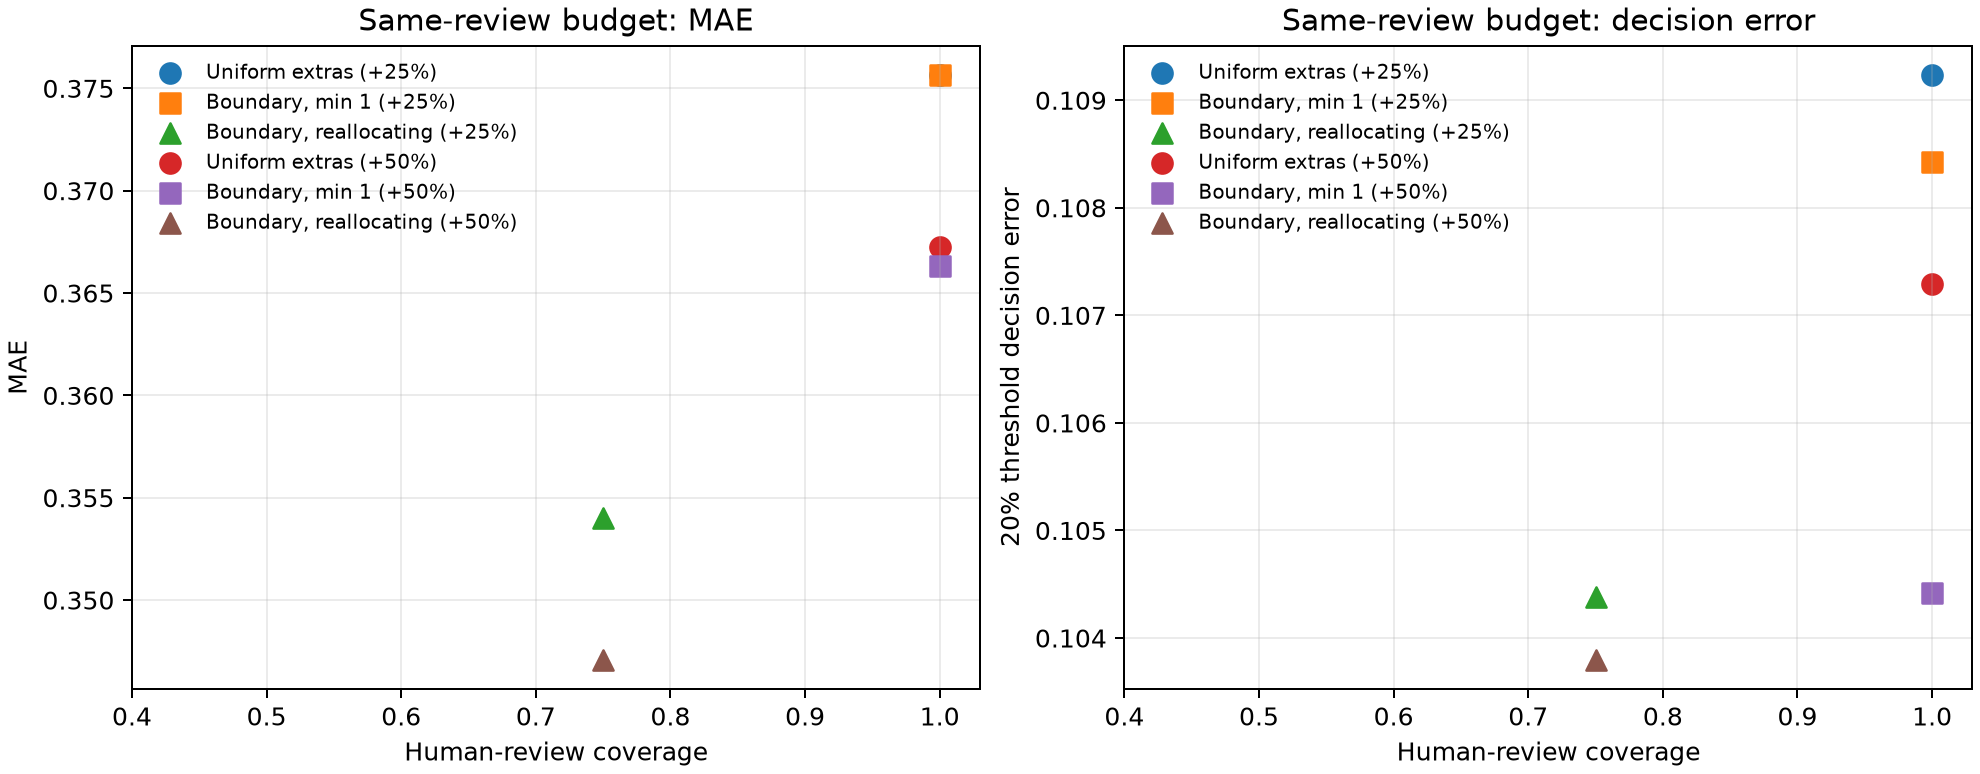
图8-6 的数据来自 results/peer_review_allocation_sensitivity.csv,把人类评审覆盖与 MAE、决定误差并列,标记额外比例 0.25 和 0.50 下的三种策略。图的坐标只覆盖相同总评审预算的六行;它不能证明策略的普遍优越性,也不能把 ai_only_coverage 或 group_resource_gap 直接命名为公平。
8.4 跨模拟的外推防火墙
三项模拟放在一起后,能够共享的是一条机制问题的排列,而不是效应量的合并。SIM-8.1 讨论在固定筛选深度下,排序代理如何同时改变召回、主题覆盖和组集中度;SIM-8.2 讨论在固定规模的每轮合成候选总体和验证预算下,信号强度与确认权重如何改变 recall、单次 FDP、信念组 gap 和验证负担;SIM-8.3 讨论在固定合成稿件和评审预算下,混合权重、共同误差、能力 profile 与分配策略如何改变 MAE、决定误差、WSD、共识、覆盖和资源差距。三者的指标分母不同,生成器不同,参数网格不同,不能把 SIM-8.1 的 recall、SIM-8.2 的 FDP 和 SIM-8.3 的 MAE 放进同一个排名,也不能用一项的正向模式抵消另一项的风险模式。
这些结果只支持条件性的机制描述:在指定合成生成器、参数网格、seed 20260925 和重复次数下,某方法的重复分布出现了某个方向、某个均值或某个分位数;改变相关性、先验、预算、共享误差、异质性或分配规则,关系就可能改变。q025/q975 与 p025/p975 只承担重复分布描述;defined_fraction 决定未定义指标能覆盖多少重复。外部效度仍然是高风险事项,因为全部标签、分数、质量真值、阈值、组、能力与信念都由脚本构造,且只有一个 seed。SIM-8.3 的 AI 质量载荷、共享 AI 误差与 ai_only_coverage 是抽象构造,未按任何具体模型代际校准,不代表当前模型水平;因此其结论不因模型迭代而过时,也不因新模型发布而增强。SIM-8.3 没有独立负控,SIM-8.1 与 SIM-8.2 的负控只通过构造边界,结构不变量和 PNG 可解码也不等于科学有效性。
因此,不能从这些数字推出真实文献数据库的召回、综述完整性、筛选工时、AI 产品性能,不能推出真实创意发现率、科学家确认偏误、FDR/FWER 或科研产出,也不能推出真实评审者能力、录用质量、身份或地位歧视、公平、编辑行为、评审收费或资源政策效果。外部文献可以支持问题选择、指标定义、验证负担和制度边界;内部 CSV/PNG 只提供透明的机制敏感性接口。解释这些结果时,模拟节点、完整条件、指标、分母、重复分布分位数和 defined fraction 都必须同时保留。